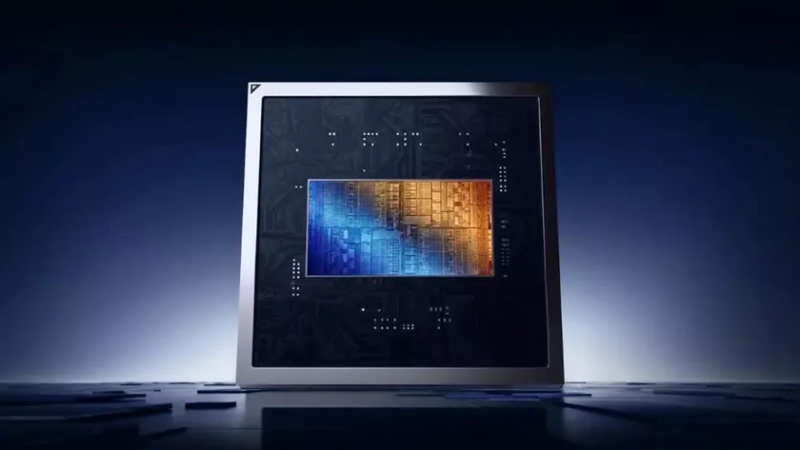
Архитектура DX-M2 позволяет запускать большие языковые модели с минимальными энергозатратами. Источник: DeepX
Южнокорейская компания DeepX завершила разработку второго поколения своих ИИ-ускорителей — DX-M2. Этот чип призван перенести вычисления больших языковых моделей (LLM) из облачных центров обработки данных непосредственно на периферийные устройства: от промышленных роботов и дронов до пользовательских ноутбуков. Ключевой особенностью является высокая энергоэффективность при значительной вычислительной мощности.
Производительность и энергоэффективность DX-M2
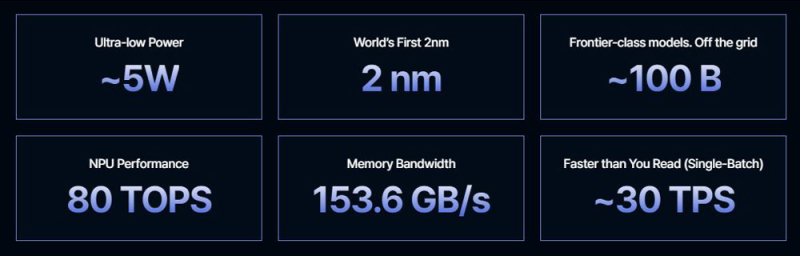
Чип DX-M2 оптимизирован для работы с LLM объемом от 20 до 100 миллиардов параметров, обеспечивая скорость генерации текста 10–30 токенов в секунду. Это соответствует комфортному взаимодействию в реальном времени. При этом, TDP чипа составляет всего 5 Вт, что является значительным достижением для заявленного уровня производительности.
По сравнению с первым поколением DX-M1 (2024 год), которое имело производительность 25 TOPS и ориентировалось на компьютерное зрение, новая модель DX-M2 выдает 80 TOPS. Такой прирост стал возможен благодаря новой архитектуре нейропроцессора (NPU) и переходу на 2-нм техпроцесс Samsung. В 2024 году DeepX привлекла 80,5 млн долларов инвестиций, в том числе, на разработку решений на базе передового 2-нм процесса.
Инновации в подсистеме памяти
Одним из традиционных «бутылочных горлышек» для ИИ-вычислений является скорость обмена данными между процессором и оперативной памятью. В DX-M2 пропускная способность памяти увеличилась втрое, достигнув 150 ГБ/с. Однако основное новшество — это совместная разработка с Samsung технологии LPDDR5x-PIM (Processing-in-Memory).
PIM-технология, ставшая важным трендом в 2026 году, позволяет выполнять часть вычислений непосредственно внутри микросхем памяти. Это особенно критично для операций умножения матриц на векторы, которые являются основой работы языковых моделей. Хотя результаты моделирования демонстрируют ускорение генерации токенов для Llama 3.1 8B в 6,7 раза, DeepX ставит более прагматичную цель: удвоение скорости при сохранении 5-ваттного энергопотребления. Это особенно актуально в контексте растущей стоимости памяти Samsung, что повышает значимость эффективного использования каждого гигабайта.
Платформа DX-Newton и перспективы развития
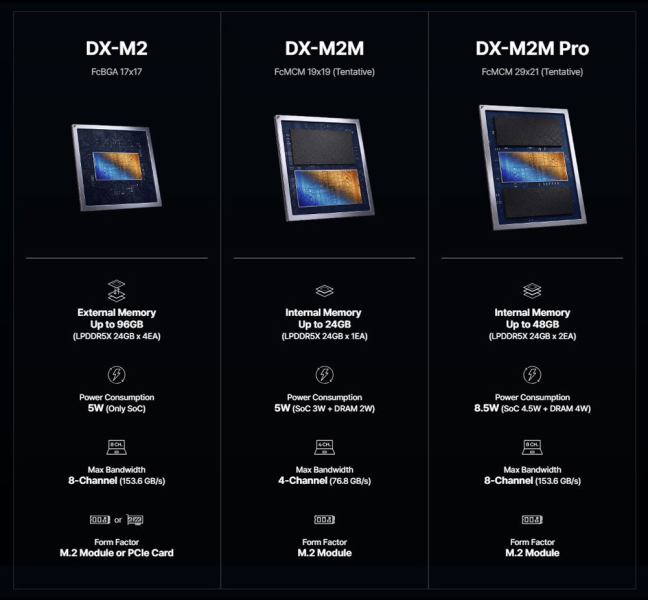
DeepX активно нацелена на рынок робототехники, где лидирующие позиции занимает Nvidia. Для упрощения миграции разработчиков на свои решения, компания представила платформу DX-Newton. Она позволяет заменить API Nvidia Isaac ROS, значительно сокращая затраты на адаптацию кода. По словам основателя DeepX Локвона Кима (Lokwon Kim), такой переход потенциально способен увеличить время автономной работы робота в 20 раз.
DeepX уже сотрудничает с Hyundai Motor Group Robotics Lab и планирует интеграцию с процессорами Intel Core Ultra через OpenVINO. Массовый выпуск DX-M2 запланирован на осень 2027 года. В долгосрочной перспективе, в 2028 году, ожидается анонс DX-M3 с чиплетной архитектурой и поддержкой LPDDR6, что обещает поднять локальные ИИ-вычисления до уровня экса операций в секунду.