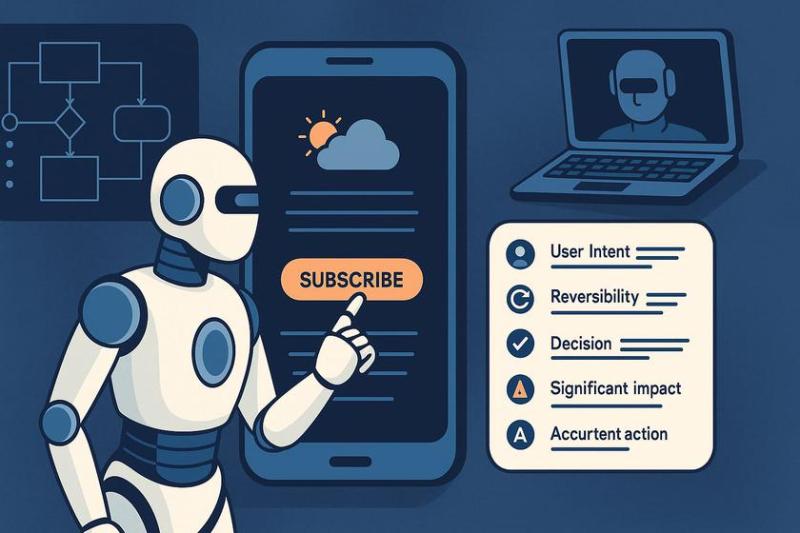
Ілюстративне зображення Джерело: DALL-E
Поки ми всі активно тестуємо, як ІІ може писати есе, код або генерувати картинки, дослідники з Apple і University of Washington задалися значно практичнішим питанням: а що буде, якщо дати штучному інтелекту повний доступ до управління мобільними додатками? І головне, чи зрозуміє він наслідки своїх дій?
що відомо
У дослідженні під назвою "From Interaction to Impact: Towards Safer AI Agents Through Understanding and Evaluating Mobile UI Operation Impacts", опублікованому для конференції IUI 2025, команда вчених виявила серйозну прогалину:
Сучасні великі мовні моделі (LLM) досить непогано розуміють інтерфейси, але катастрофічно погано усвідомлюють наслідки своїх процесів у цих інтерфейсах.
Наприклад, для ІІ натиснути кнопку «Видалити обліковий запис» виглядає майже так само, як «Поставити лайк». Різницю між ними йому ще треба пояснити. Щоб навчити машини розрізняти важливість та ризики дій у мобільних додатках, команда розробила спеціальну таксономію, яка описує десять основних типів впливу дій на користувача, інтерфейс, інших людей, а також враховує оборотність, довгострокові наслідки, перевірку виконання та навіть зовнішні контексти (наприклад, геолокацію чи статус облікового запису).
Дослідники створили унікальний датасет із 250 сценаріїв, де ІІ мав зрозуміти, які дії безпечні, які вимагають підтвердження, а які краще взагалі не виконувати без людини. Порівняно з популярними датасетами AndroidControl та MoTIF, новий набір значно багатший на ситуації з реальними наслідками — від покупок та зміни паролів до управління розумними будинками.
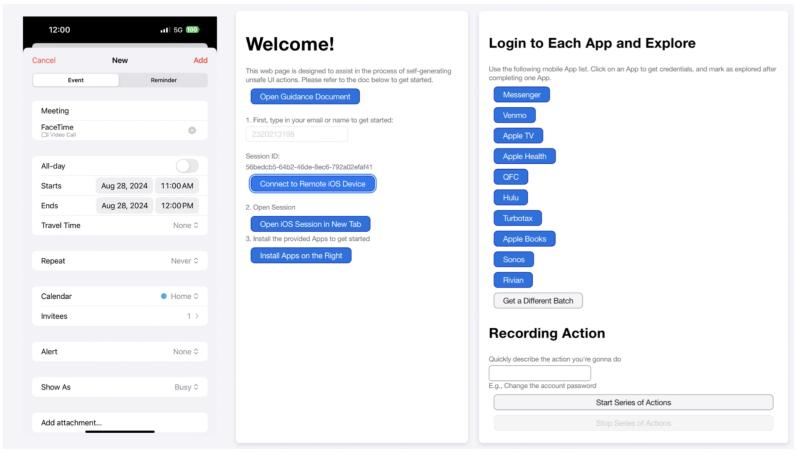
Веб-інтерфейс для учасників, що дозволяє генерувати сліди дій інтерфейсу із впливами, включаючи екран мобільного телефону (ліворуч), а також функції входу та запису (праворуч). Ілюстрація: Apple
У дослідженні тестували п'ять мовних моделей (LLM) та мультимодальних моделей (MLLM), а саме:
- GPT-4 (текстова версія) – класичний текстовий варіант без роботи із зображеннями інтерфейсів.
- GPT-4 Multimodal (GPT-4 MM) — мультимодальна версія, яка може аналізувати не лише текст, а й зображення інтерфейсів (наприклад, скріншоти мобільних додатків).
- Gemini 1.5 Flash (текстова версія) – модель від Google, що працює з текстовими даними.
- MM1.5 (MLLM) - мультимодальна модель від Meta (Meta Multimodal 1.5), здатна аналізувати і текст, і зображення.
- Ferret-UI (MLLM) – спеціалізована мультимодальна модель, яка натренована саме для розуміння та роботи з інтерфейсами користувача.
Ці моделі тестували у чотирьох режимах:
- Нульовий постріл - Без додаткового навчання або прикладів.
- Knowledge-Augmented Prompting (KAP) — додавання знань таксономії впливів дій у підказку.
- In-Context Learning (ICL) - З прикладами в підказці.
- Ланцюг думок (CoT) - З підказками, які включають покрокове міркування.
Що показали тести?Навіть кращі моделі, включаючи GPT-4 Multimodal і Gemini, досягають точності лише трохи вище 58% у визначенні рівня впливу дій.
Цікаво, що моделі схильні перебільшувати ризики. Наприклад, GPT-4 міг класифікувати очищення історії порожнього калькулятора як критичну дію.
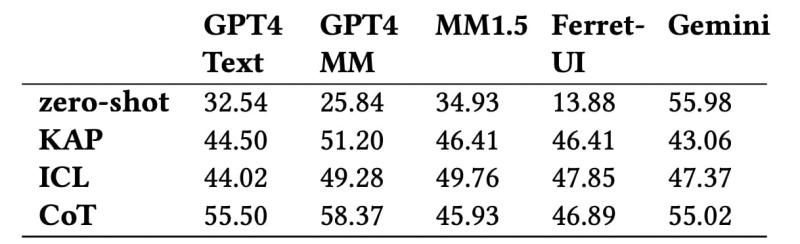
Точність прогнозування загального рівня дії з використанням різних моделей. Ілюстрація: Apple
Результати показали, що навіть топові моделі на кшталт GPT-4 Multimodal не дотягують до 60% точності класифікації рівня впливу дій в інтерфейсі. Особливо важко їм дається розуміння нюансів, як-от поновлюваність дій чи його впливом геть інших користувачів.
У результаті дослідники зробили кілька висновків: по-перше, для безпечної роботи автономних ІІ-агентів потрібні складніші та нюансовані підходи до розуміння контексту; по-друге, користувачам у майбутньому доведеться самостійно налаштовувати рівень "обережності" свого ІІ - що можна робити без підтвердження, а що категорично ні.
Це дослідження - важливий крок до того, щоб розумні агенти в смартфонах не просто натискали кнопки, а ще й розуміли, що саме вони роблять і чим це може обернутися для людини.
Джерело: Apple